用AI写精神科综述,虚构不存在的文献只是众多风险之一。检索不完整、筛选标准执行不一致,以及数据和限定条件的遗漏,都有可能影响证据判断。尤其需要警惕数字提取错误,以及整齐的表格和流畅的文字所掩盖的信息错漏。
进入证据整合与写作环节后,AI还有可能轻描淡写地抹平研究间的差异,将相互矛盾的结果写成一致结论,或夸大研究发现。多轮对话中,大模型也可能会不断迎合使用者的既有观点,使选题、证据缺口及结果解读逐渐偏向预设但未必成立的判断。
为防范这些风险,需要把AI产出视为待核查的初稿:检索由研究者在数据库中实际执行,提取数据逐项回查原文,证据整合保留分歧与局限。提示词再完善,也不能替代专业判断;综述内容的最终责任仍由署名作者承担。
选题、检索、筛选、提取和整合证据,是综述成稿前的主要工作。近五年来,仅Biological Psychiatry系列期刊收到的非约稿综述投稿量就增加了一倍以上。大语言模型(LLM)能帮助作者阅读外语文献,筛查大量记录,把零散资料整理成表格。然而,它的真实能力和使用方法都在变化,对其局限性的认识以及有效使用的指导仍不充分。
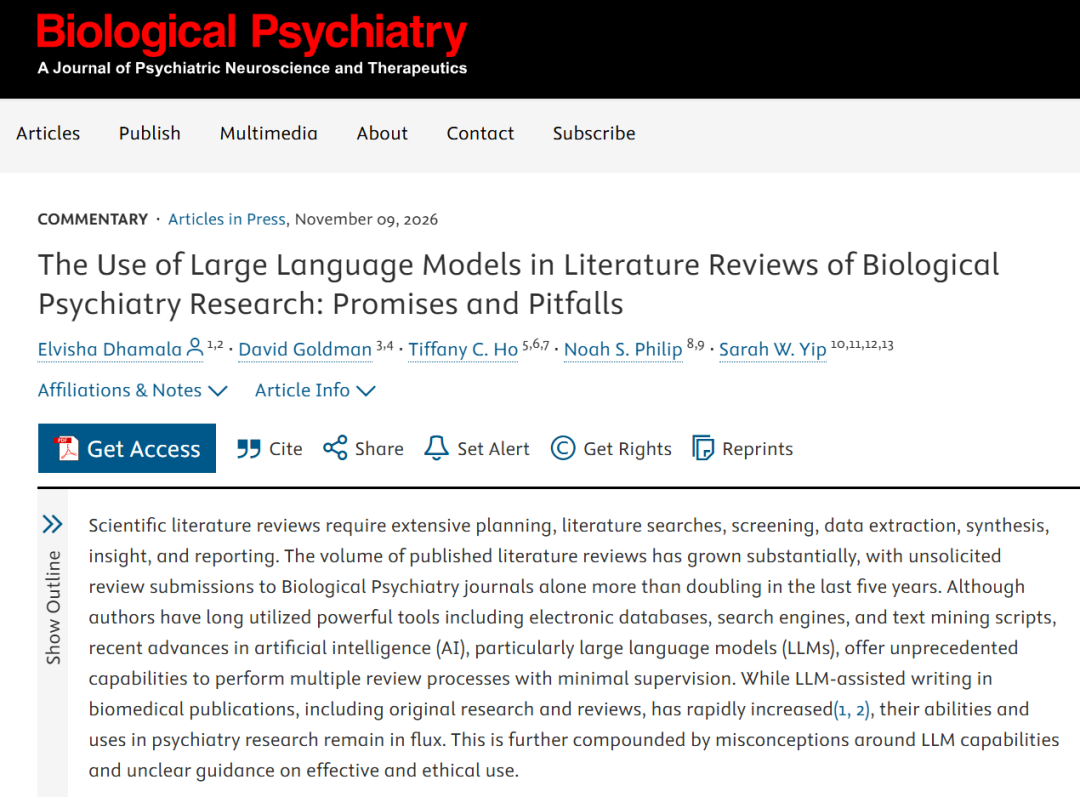
11月9日,Dhamala等在Biological Psychiatry在线发表评论文章,讨论LLM如何参与生物精神病学文献综述的撰写。作者介绍了大模型的常见用途和提示词设计方法,并从准确性、可重复性、透明性、偏倚、人工监督及责任归属六方面分析风险与应对办法。以下介绍作者的主要观点。
提示词的五大要素
专业角色、背景信息、明确任务、输出结构和迭代修订,构成了提示词的五项要素:
★ 专业角色
需要具体到正在做的工作。「你是一名科学家」过于笼统,可以将角色进一步限定为「正在开展系统性文献综述、准备向同行评议学术期刊投稿的研究者」。
★ 背景信息
要说清文章写成何种体例、写给谁。例如,「儿童创伤后
★ 明确任务
要细化所谓的「查找相关研究」。例如,要求大模型列出相关数据库,提供数据库专用检索式;纳入近20年发表、使用大规模数据集且样本量≥100的研究,排除病例报告、评论和仅研究成年人的文章。无法获取全文时也必须明确说明。
★ 输出结构
需约定资料以何种形式交付。与笼统地要求「总结发现」相比,可以要求大模型以结构化字段的形式总结,包含题名、作者、期刊、发表年份、研究问题、主要发现等。主要发现还要具体到创伤类型及严重程度、抑郁症状严重程度,以及症状出现与创伤暴露的时间关系等。
★ 迭代修订
在首轮输出基础上继续工作时,先给汇总表补入数据集、样本特征、方法、效应方向与大小及局限,标出研究间的结果冲突和可能限制解释的方法学问题。之后按主题归组,增列共同发现;资料整理充分后,再按主题组织章节,综合不同研究,呈现一致之处、分歧和研究空白。成稿后,还要核查引文是否真实、引用是否准确。
研究者拿到首轮输出后,再检查错误、补充要求或调整范围。同一个任务交给不同模型,回答可能不一样,甚至相互矛盾,因为它们的训练资料、架构和既有信息并不相同。所用模型及版本、提示词、参数和日期应记录并披露,对话也要保存。关键任务重复运行,可用来检查前后是否一致;提示词无论怎样修改优化,独立核查都不能省略。
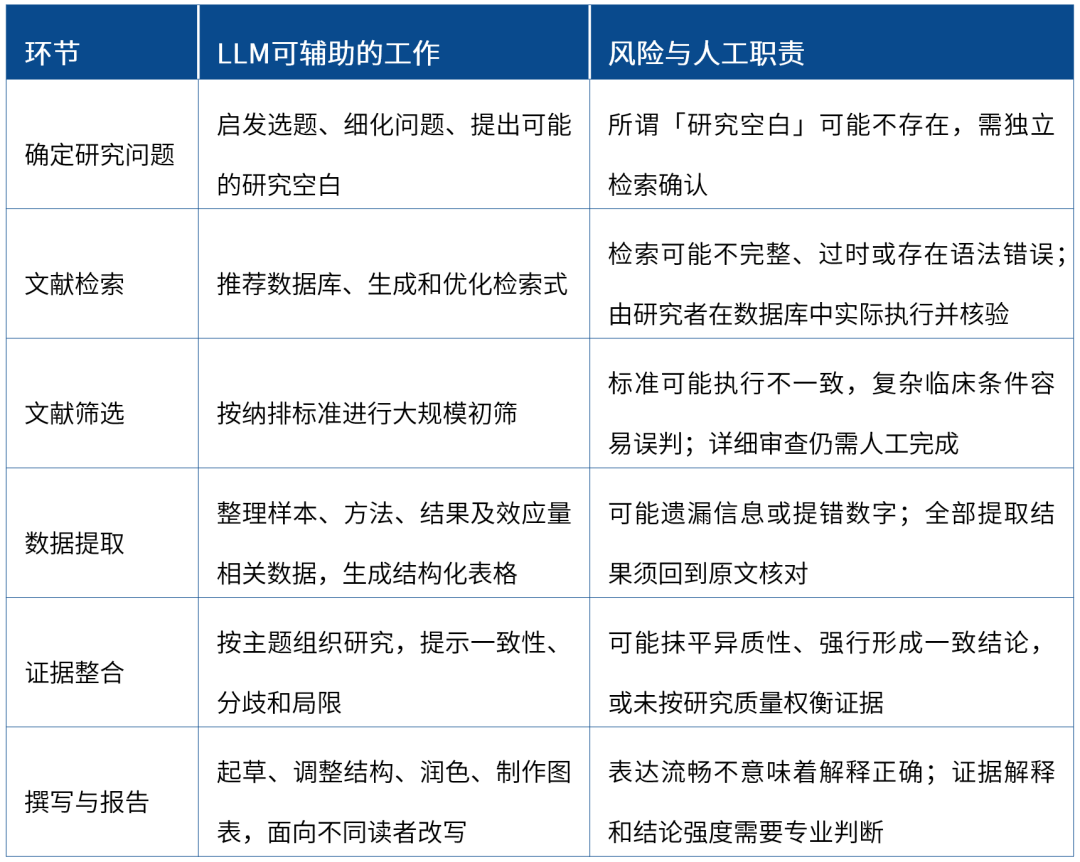
综述各环节的辅助用途与核查要点
★ 研究问题与综述方案
选题讨论中,作者会向大模型表达自己的想法和偏好。这些交流看似只是简单的沟通或询问,实则可能影响后来的回答,使大模型越来越认可既有假设。它提出的所谓「研究空白」,有时只是顺着研究者的观点得出的结果,未必真正成立。制订方案需要明确研究问题、范围、方法和纳入标准,大模型提出的证据缺口也要经人工检索确认,并在综述中交代核实步骤。
提示词中可以加入质疑假设、寻找反面论据的要求。还应留意回答中哪些人群、语言和理论观点被反复强调,哪些几乎没有出现。大模型的输出还有可能忽略文献中代表性不足的人群,以及一些高度创新的观点;这部分需要靠人工检索补充。
★ 文献检索
检索式可以请大模型起草和修改,文献间的引用关系也可以让它协助梳理。执行检索时,作者仍要回到PubMed、Web of Science等数据库。多数大模型无法在所有数据库中实时检索,生成的语句也可能看似专业,但并不符合目标数据库的语法。换一位作者重新运行、比较所得结果,有助于检查检索是否一致。
作者还必须澄清以下事实:大模型究竟有没有读到全文,因为付费文章、补充材料都可能超出它的访问范围。据估计,大模型可能无法获取超过60%的科研论文全文。因此,未能获取全文的文章需明确标出,不能把大模型给出的内容一概当作基于完整资料的回答。数据库覆盖和访问权限带来的限制,也不是多改几遍提示词就能完全解决的。
表1. 综述各环节的辅助用途与核查要点
★ 文献筛选
一项研究是否符合纳入条件,有时取决于临床病史中的细节或多个因素之间的关系。重要信息如果放在图中,也可能被漏掉。对于这些情况,明确写出入排标准仍不足以保证大模型判断正确。
纳入和排除的理由可以一并要求模型给出,供研究者审查。然而,与其他输出一样,这些解释同样是大模型生成的内容,不能据此还原真实的判断过程。至少需要由人工筛查一部分文献,看看错误是否集中在某类情况,再有针对性地调整提示词。
★ 数据提取与核验
逐篇汇总神经影像坐标,或者临床研究的入组条件,往往要花不少工夫,大模型可以协助完成这项工作。提取准确性可能有很大差异,分类和文字信息通常比数值提取得更可靠。错误更多出在信息提取错误,而不是编造;漏掉内容本身就很难发现;汇总表看起来很整齐漂亮,并不能说明提取完整。
同一类资料,在不同研究中未必按同样的方式报告,如有的放在正文中,有的置于表格中;效应量可能以回归系数表示,也可能报告为比值比,这些差异都可能影响提取的可靠性。任务中需写清输出字段,要求数值附上来源,遇到含义不清或靠推断得到的数值,应另作标记。
核验有两种可尝试的做法:大模型A负责提取,另一个独立大模型B负责复核;或者让多个大模型如AB分别提取,再请第三个大模型C找出不一致的地方。这样有望在提高可靠性的同时保留效率优势。然而,大模型之间的分歧仍由研究者处理,所有提取数据最终也都要由研究者对照原始资料确认。
★ 证据整合
将研究按主题归组后,可以分别梳理支持和反驳某一观点的证据,再独立核查。大模型能帮助标记影响结果解读的局限性,但研究在综合判断中究竟占到多大权重,还要看方法是否严谨、质量如何。提示词也需要明确要求保留异质性,避免将复杂或相互矛盾的结果整理成表面上一团和气的结论。
有些发现有可能会反复出现,貌似很有看点,但其实是共同的方法学伪象,未必代表真正有意义的效应。识别这种情况需要专业知识,单凭改良提示词无法替代这项判断。人类也会在整合证据时出错;多人合作的综述中,对其他作者负责的部分同样要审查。
★ 结果解释与论文写作
初稿完成后,大模型还可以帮助改进表述,检查章节间的结构是否一致。然而,一篇看上去流畅通顺的综述,仍有可能把结论写得过满,漏掉重要局限性,或者没有把结果放回所属专业领域的背景中理解。检索、筛选、提取时留下的问题也可能影响后面的解释。大模型输出速度过快,语气过于自然流畅,还可能让作者放松警惕,忽略检查。
长时间与大模型讨论后,研究者的偏好可能不断得到强化,结果的解读也可能偏向预设观点。通过新建对话,使用不同大模型,或明确要求质疑假设,这种「迎合偏倚」或可得到部分缓解。综合结论要交由熟悉该领域的研究者进行批判性的审查;每位署名作者都对综述内容负责。
本文作者也使用了Claude Opus,具体用法是让它协助组织文章结构、改善措辞和语法,并修订正文与表格。文献检索、对研究结果的解读及未经监督的内容生成都不在这次使用范围内。作者审阅并核实了全部内容,才最终定稿。
大模型有望加快综述撰写并提高严谨性,但前提是研究者做好监督、核查并披露使用情况。技术仍在发展,相关政策也会变化,具体用法仍需不断调整。
2026-01-06
文献索引:Dhamala E, Goldman D, Ho TC, Philip NS, Yip SW. The use of large language models in literature reviews of biological psychiatry research: promises and pitfalls. Biol Psychiatry. 2026. doi:10.1016/j.biopsych.2026.11.002.
点击「阅读原文」可查看及检索历史文章。
 我要投稿